The Lottery Ticket Hypothesis
유형: 논문 · 저자: Michael Carbin, Jonathan Frankle · 출처: MIT CSAIL · 별점: ⭐️⭐️⭐️⭐️⭐️
결론
큰 규모의 무작위로 초기화된 신경망 내부에는 전체 모델과 동등한 성능을 낼 수 있는 ‘작은 부분 신경망(subnetwork)’이 존재하며, 이를 찾아 별도로 학습시키면 원래 모델과 비슷한 성능을 달성할 수 있다는 주장
⇒ 기존 신경망은 실제로는 필요 이상으로 크며, 그 안에는 처음부터 잘 작동할 ‘작은 구조’가 숨어 있다
⇒ “처음부터 구조적으로 유리한 조합이 존재했다”는 주장
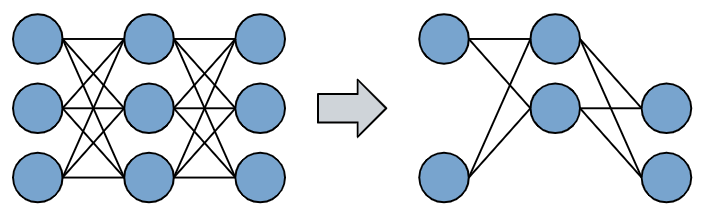
→ 이런 부분 신경망을 “당첨 복권(winning ticket)”이라고 부름
전제
- 현대 딥러닝 모델은 매우 많은 가중치(파라미터)를 갖고 있으며, 이 중 상당 부분은 학습 성능에 필수적이지 않을 수 있다
- 무작위로 초기화된 네트워크라도 적절한 부분 구조(subnetwork)가 학습에 유리한 조합으로 존재할 수 있다
- pruning 기반 식별: 원본 모델을 학습하고, 중요도가 낮은 가중치를 제거하고, 남은 가중치를 원래 초기값으로 되돌려 재학습하는 방식으로 winning ticket을 찾는 이론
식별 알고리즘
- 네트워크를 무작위 초기화하고 통상적으로 학습
- Iterative Magnitude Pruning(IMP) 같은 기법으로 중요도가 낮은 가중치를 제거
- 남은 가중치를 초기화 상태로 되돌린 후, 해당 subnetwork만 따로 다시 학습
- 이 학습된 subnetwork(=winning ticket)가 원래 네트워크와 비슷한 성능을 내면 만족
결과
- 이미지 분류 데이터셋(MNIST, CIFAR10) 기준으로 원래 모델의 10–20% 수준만 남긴 winning ticket이 동일하거나 더 빠른 학습, 비슷한 성능을 보임
후속 연구
- The Lottery Ticket Hypothesis와 그 후속 연구들 리뷰
- EXAMINING THE ROLE OF NORMALIZATION IN THE LOTTERY TICKET HYPOTHESIS
- LTH가 대형 모델에서 깨지는 원인은 정규화(Normalization) 외부에 있다
- 대규모 모델(ResNet, Transformers)에서는 초기화 단계에서 찾기 어렵고, 학습 초반 단계에서 subnetworks를 찾는 방식이 더 효과적이다
- Early Ticket
- 학습 초반에 이미 중요한 연결을 추정하려는 시도
- “끝까지 학습하지 말자”
- Data-free / Gradient-free
- 실제 데이터 없이 구조적 중요도를 계산하려는 접근
- Structured Pruning
- 개별 weight가 아니라 채널, 레이어 단위로 제거
인사이트
- 미래는 더 큰 모델이 아니라, 무엇을 남기고 무엇을 버릴지 처음부터 알고 설계된 모델에 있다
- 인공지능 프로그래밍을 일반적 프로그램으로 바꿔도 문제가 없을 수 있다.