프로젝트 > 대학 합격 확률 계산 AI
대학 합격 확률 계산 AI
구분
도구
한 줄 소개
입시 데이터로 대입 합격 확률을 계산하는 알고리즘
코드 저장소
없음
최근 업데이트
2024.12.01
설명
개요
결론
- 입시 데이터를 기반으로 대입 합격 확률을 계산하는 알고리즘을 AI 형태로 제작해 납품
- 의뢰자: 대입 컨설턴트
프로젝트 요약
- 의도 및 맥락:
- 학생에게 직접 보여주는 서비스가 아니라, 컨설팅 사업 내부에서 활용되는 의사결정 보조용
- 따라서 별도의 UI는 필요하지 않음
- 빠른 수정과 검증, 수식 조정을 위해 구현 환경은 스프레드시트 기반으로 선택
- 파이프라인
- GPT API, MAKE, Spreadsheet를 결합해 구성
- 유사 서비스
- 학생에게 직접 보여주는 서비스가 아니라, 컨설팅 사업 내부에서 활용되는 의사결정 보조용
- 목표: 상위 경쟁자 이탈 시나리오 기반으로 내 순위 이동 확률 계산
- 결과: 70% 이상 정확도 확인
지금 다시 한다면?
- 굳이 AI로 만들 이유가 있었을까?
- The Lottery Ticket Hypothesis에서 보여준 것처럼 인공지능 프로그래밍을 일반적 프로그램으로 바꿔도 문제가 없을 수 있다.
- 대안: 초기엔 일반 프로그램으로 구현 → 누적 데이터 ≥1,000 확보 후에 AI 단계적 도입
기획
문제 정의
- 대입 컨설팅
- “이 학생이 안전한지”, “왜 이 구간에서 위험한지”, “표본상 허수를 얼마나 제거해야 하는지” 등을 설명하고 판단하는 능력이 중요
- 그러나 이러한 판단은 대부분 컨설턴트의 경험 등 정량화되지 않은 직관에 의존
- 시장의 구조적 문제
- 학생들은 표본 분석 자체를 완전히 신뢰하지는 않지만, 불확실성과 불안을 해소하기 위해 고액의 컨설팅 비용을 지불
설계
- 1차 사용자는 학생이 아닌 컨설턴트로 정의
- 목표는 합격을 맞히는 예측 AI가 아니라, 컨설팅 판단을 지원하는 계산기
- 솔루션
- 합격 컷 예측 X
- 단일 점수만으로는 합격 여부를 설명할 수 없는 구조
- 실제 결과를 예측하는 방법
- 내 점수의 상대적 위치
- 상위 경쟁자들의 지망 구조
- 경쟁자들이 타지망에 합격해 이탈할 가능성
- 그러한 이탈이 동시에 발생할 확률
- 문제의 본질
- 상위 경쟁자의 이탈로 인해 내 순위가 어떻게 이동하는지에 대한 확률 분포를 계산하는 것
- 합격 컷 예측 X
솔루션 구현 방식
구성
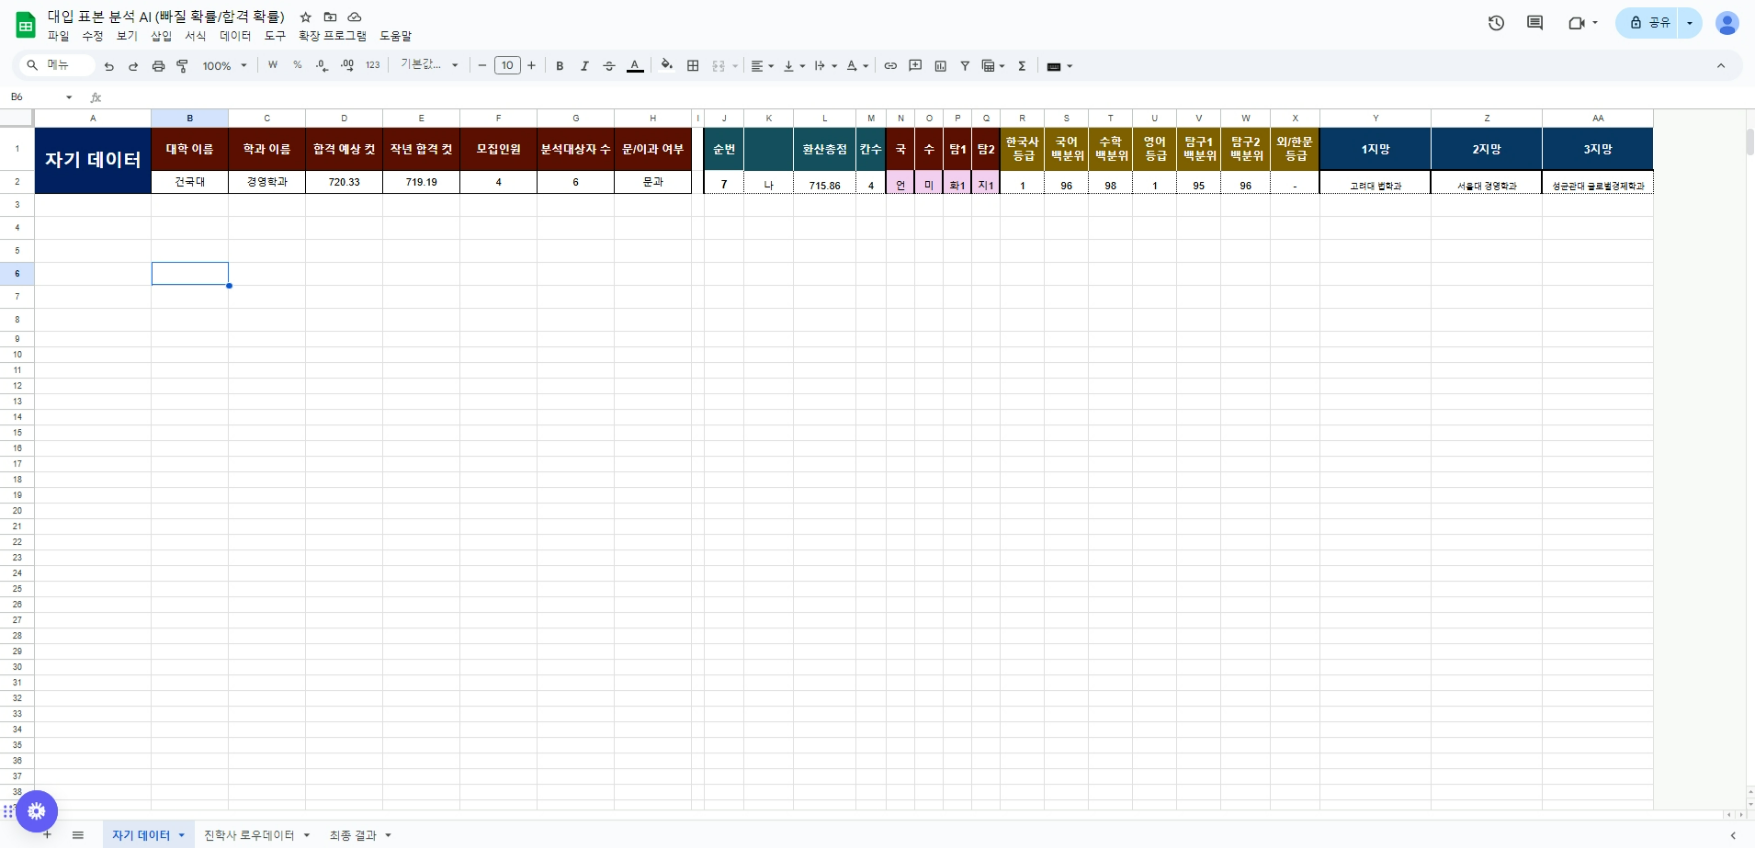
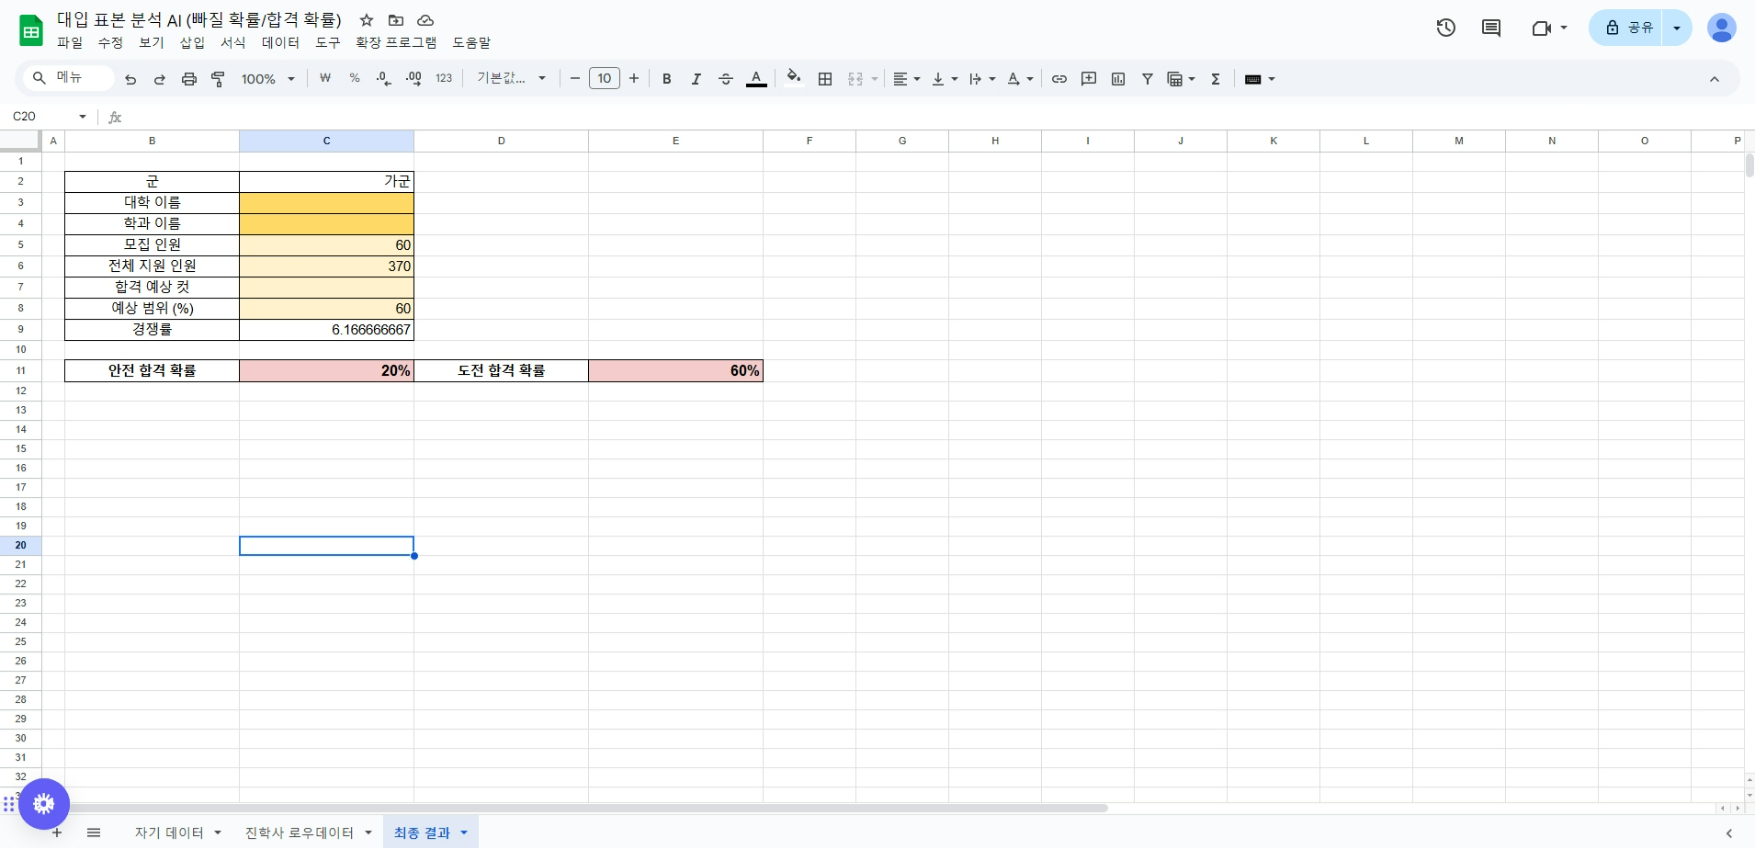
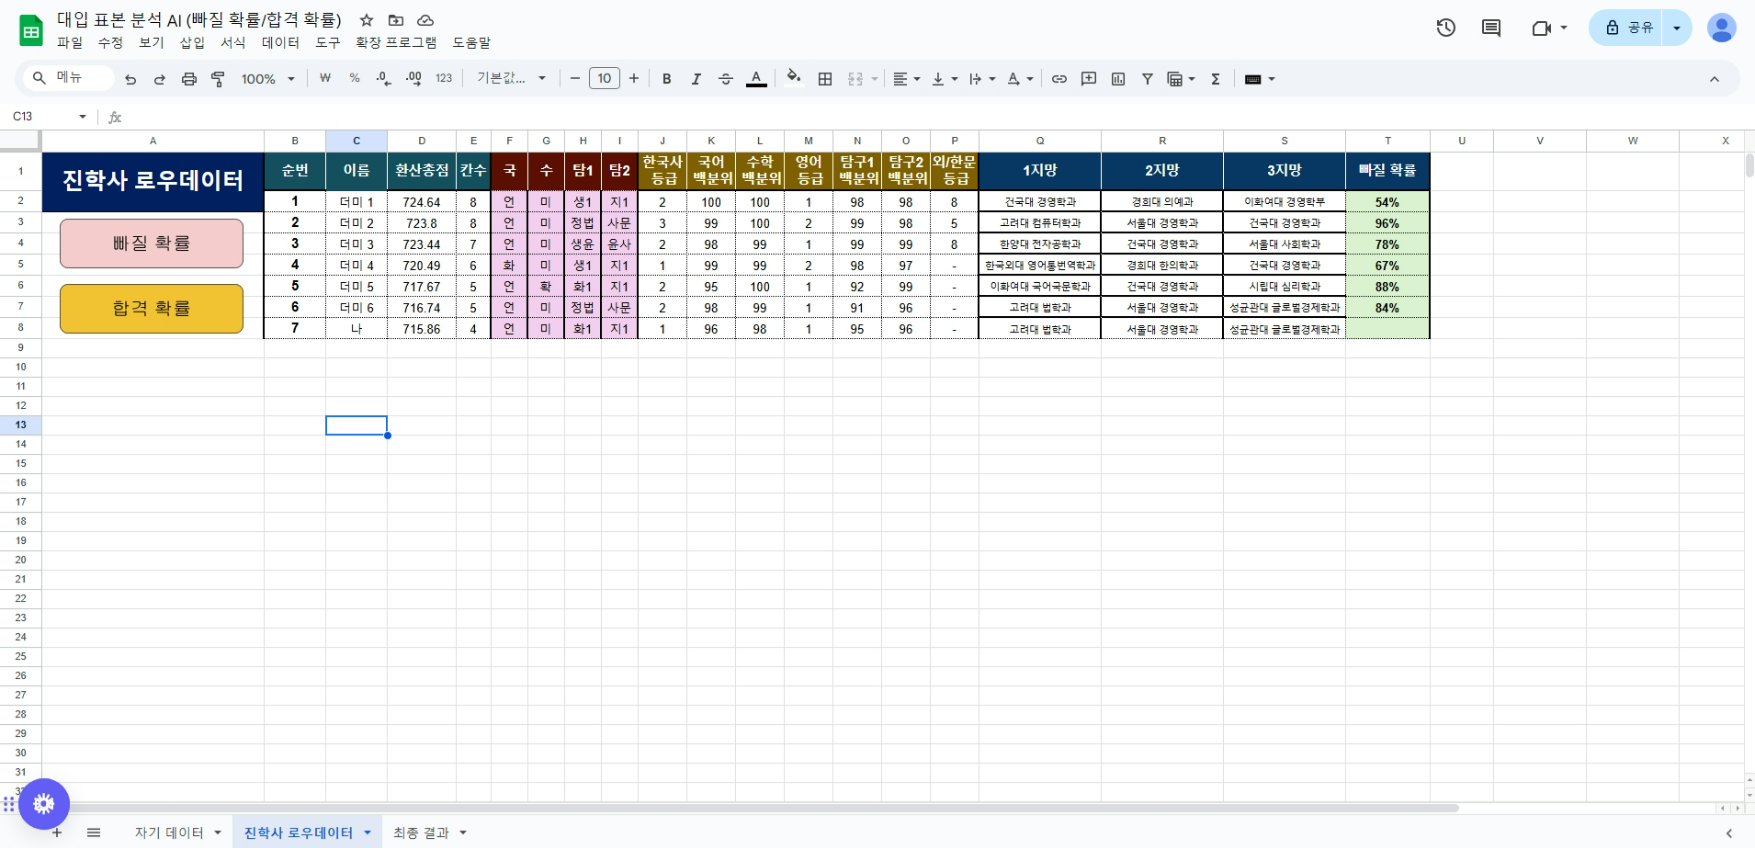
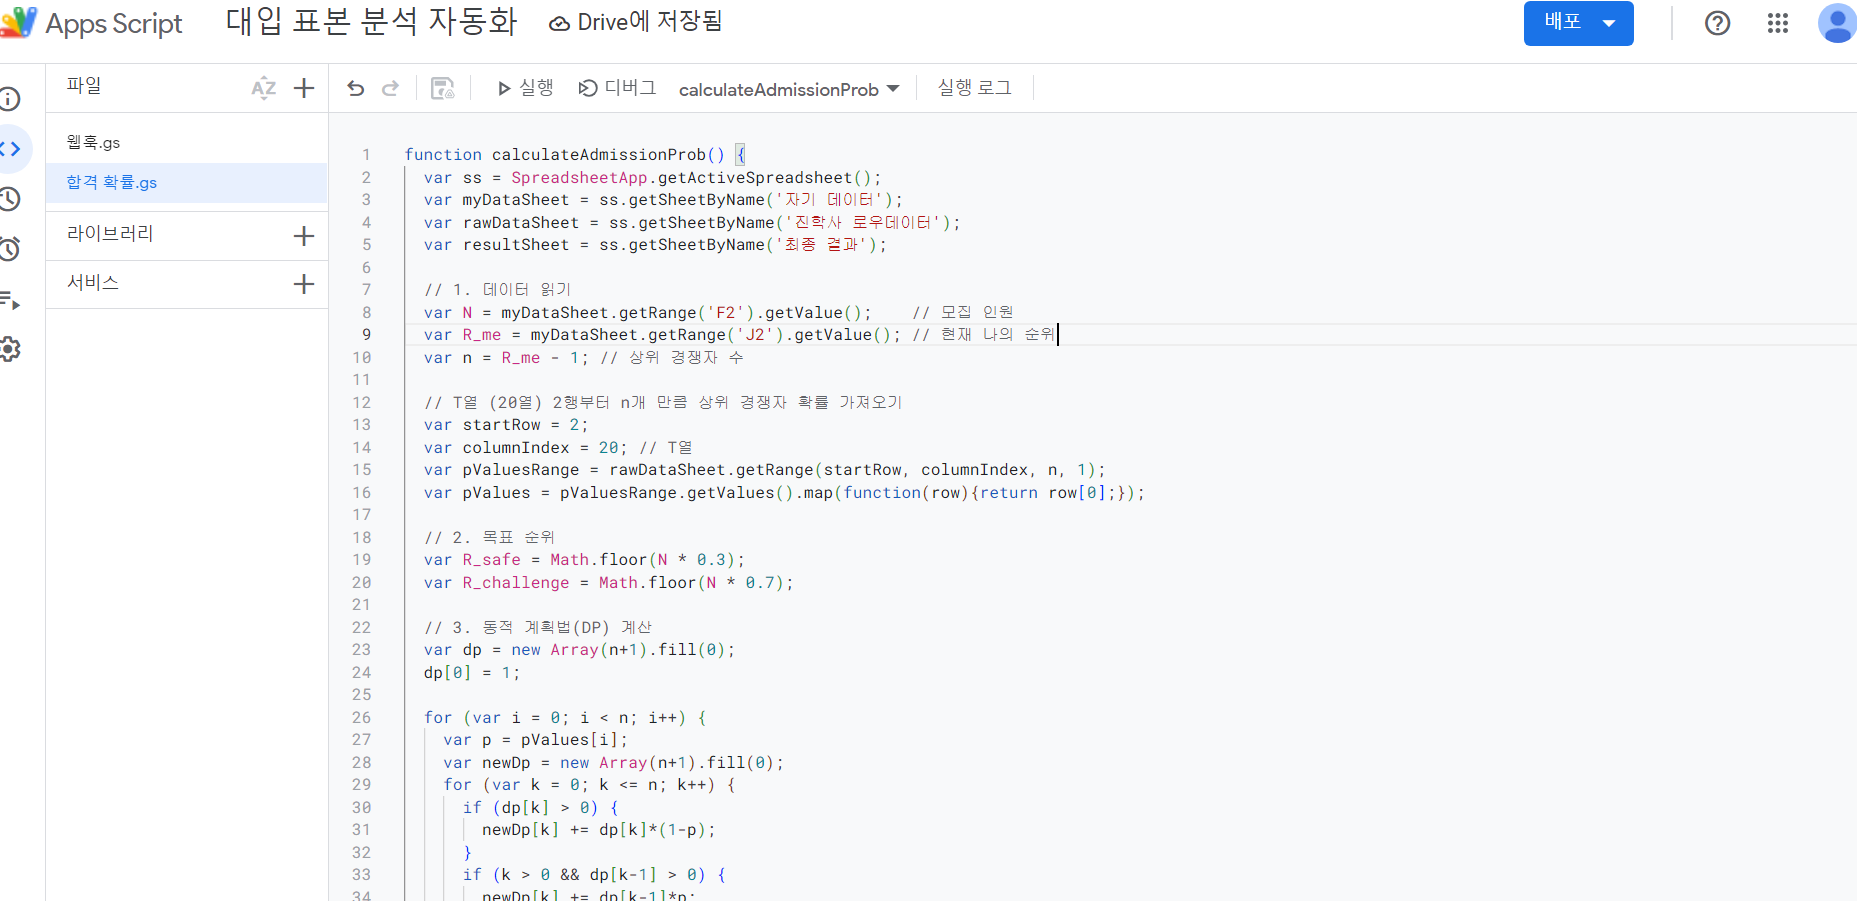
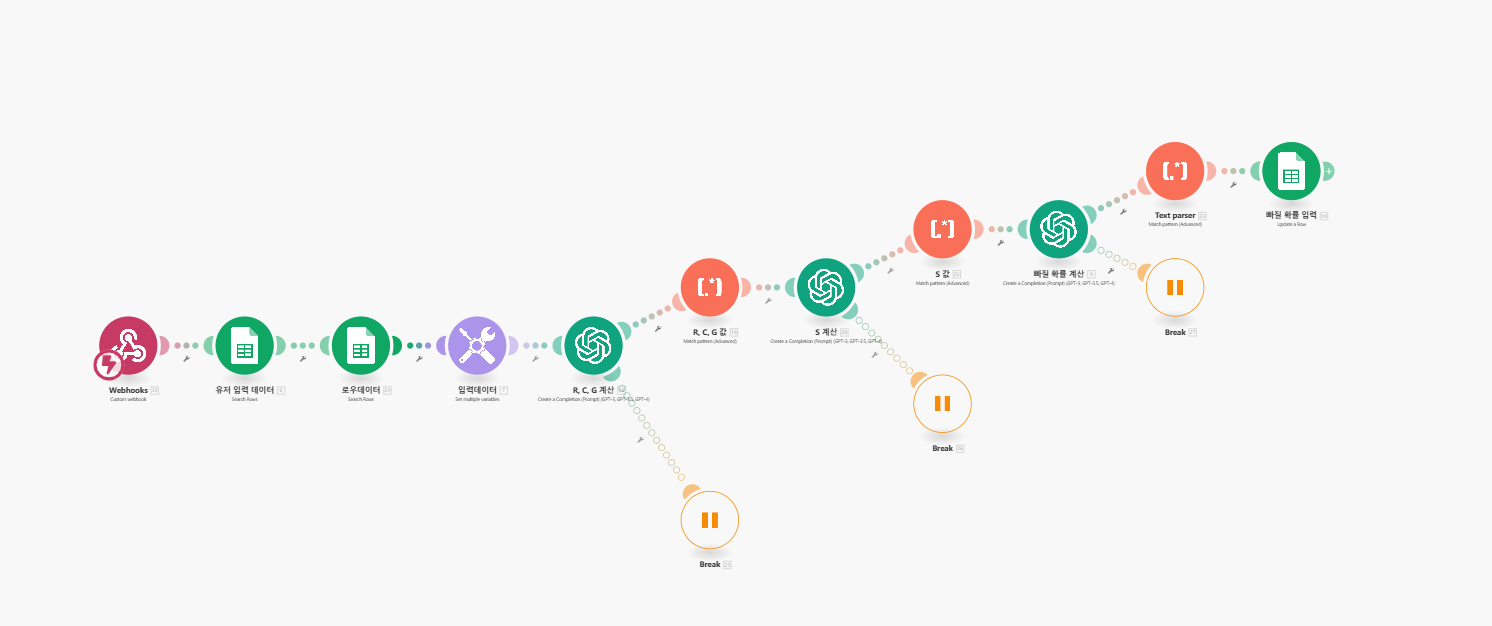
합격 확률 계산 알고리즘
사용자가 입력해야 하는 정보
- 대학 이름
- 학과 이름
- 문/이과 여부
- 합격 예상 컷
- 작년 합격 컷
- 모집 인원
- 분석 대상자 수
- 상위 경쟁자 데이터:
- 순번
- 환산 총점
- 한국사 등급
- 국어 백분위
- 수학 백분위
- 영어 등급
- 탐구1 백분위
- 탐구2 백분위
- 외국어/한문 등급
- 1지망
- 2지망
- 3지망
MAKE
입시 데이터
분석 중인 지원 대학 이름: {{6.`1`}}
분석 중인 지원 학과 이름: {{6.`2`}}
합격 예상 컷: {{6.`3`}}
작년 합격 컷: {{6.`4`}}
모집인원: {{6.`5`}}
분석대상자 수: {{6.`6`}}
문/이과여부 : {{6.`7`}}
상위 경쟁자 데이터
순번: {{24.`1`}}
환산총점: {{24.`3`}}
한국사등급: {{24.`9`}}
국어백분위: {{24.`10`}}
수학백분위: {{24.`11`}}
영어등급: {{24.`12`}}
탐구1백분위: {{24.`13`}}
탐구2백분위: {{24.`14`}}
외국어/한문등급: {{24.`15`}}
1지망: {{24.`16`}}
2지망: {{24.`17`}}
3지망: {{24.`18`}}
로지스틱 회귀 모델
* 로지스틱 회귀 모델: P(빠질 확률) = \frac{1}{1 + \exp(- (\theta_0 + \theta_1 R + \theta_2 C + \theta_3 G_c + \theta_4 S))}

* θ0=−1.386, θ1=0.4, θ2=0.1, θ3=0.1, θ4=0.7
회귀계수 정하기
가장 정확한 방법은 실제 입시 데이터를 활용해서 회귀 계수를 학습한 뒤 조정하는 것입니다.
- 지원자의 실제 지원 및 합격/불합격 여부 → 이때 각 지원자의 R,C,G,S 값.
- 실제 빠졌는지에 대한 구분 = 1: 빠짐, 0: 잔류
- 학습 결과를 통해 변수별 중요도와 상관관계를 데이터에서 도출
근데 지금 당장 우리한텐 없으니 초기값을 임의로 설정하는 수밖에 없습니다.. 이건 그냥 추측이라 정확도는 장담 못합니다. 근데 틀릴 가능성이 높을 뿐이지, 무조건 정답이 아니다는 아니니 의미는 있습니다. 추후에 결과값을 보며서 수정하면 됩니다.
초기값 가이드라인:
𝜃1(지망 순위 변수): 상대적으로 큰 영향을 가질 가능성이 높음 → 초기값 0.4~0.7
𝜃2(경쟁률 변수): 경쟁률의 영향은 보통 미미하므로 → 초기값 0.1~0.3
𝜃3(점수-커트라인 변수): 점수 격차의 비선형 효과를 반영 → 초기값 0.1~0.3
𝜃4(학교/학과 선호도 변수): 지망 간 선호도 차이의 중요성을 반영 → 초기값 0.6~0.8
[R, C, G] 변수 정의
### 지망순위 관련 변수(R)
- R=α1⋅(1지망 여부 지표)+α2⋅(2지망 여부 지표)+α3⋅(3지망 여부 지표)+α4⋅(3장 동일학교 선택 여부 지표)
- R이 높을수록 빠질 확률 증가
- α1=0.1, α2=-0.3, α3=0.3, α4=0.9
- 항목별 기여
    - 1지망 여부 지표: 지원 학교가 1지망 일시 1, 아니면 0
    - 2지망 여부 지표: 지원 학교가 2지망 일시 1, 아니면 0.
    - 3지망 여부 지표: 지원 학교가 3지망 일시 1, 아니면 0.
    - 3장 동일학교 여부 지표: 3개 지망 모두 동일한 학교면 1, 아니면 0

### 경쟁률 관련 변수(C)
- C=β1⋅(분석대상자 수/모집인원)
- C가 높을수록 빠질 확률 증가
- β1=0.01

### 점수-커트라인 격차(G)
- G = (자신의 점수 - 대상 학과 커트라인)/표준편차(σ)
- G_c=−1/∣G∣+ϵ (if G<0), −exp(−λ⋅(G−d)^2) (if G>0)
- σ=0.1, λ=50, d=0.1, ϵ=0.01
[S] 변수 정의
### 학교/학과 선호도(S)
1. 학교 선호도 차이 계산
- 메디컬 학과 특별 규칙: "의예과, 치의예과, 한의예과, 약학과, 수의예과"인 경우, 학교 선호도를 11으로 강제 치환
- 학교 선호도 차이=γi⋅max(0,(학교 선호도(지망)−학교 선호도(현재))) (i는 1지망, 2지망, 3지망)
- 학교 선호도 치환 예시
    - 현재 학과: 고려대 경영학과 (학교 선호도 = 9, 학과 선호도 = 4)
    - 1지망: 경희대 한의예과 (학교 선호도 = 11, 학과 선호도 = 5)
    - 2지망: 연세대 경영학과 (학교 선호도 = 9, 학과 선호도 = 4)
    - 3지망: 고려대 경제학과 (학교 선호도 = 9, 학과 선호도 = 4)

2. 학과 선호도 차이 계산
- 조건부 계산: 학교 선호도(지망)=학교 선호도(현재) 인 경우에만 학과 선호도 계산
- 계산식:
    * 학교 선호도가 동일한 경우: 학과 선호도 차이= 학과 선호도(지망)−학과 선호도(현재)
    * 학교 선호도가 다른 경우: 학과 선호도 차이= 0

3. 최종 S 계산
- S = \sum_{i=1}^{3} \gamma_i \cdot \max(0, (\text{학교 선호도(지망)} - \text{학교 선호도(현재)})) + \sum(\text{학과 선호도 차이})_{\text{동급 학교}}
학과/학교 선호도
#### 학교 선호도
- 메디컬 학과 학교(의예과, 치의예과, 한의예과, 약학과, 수의예과) = 11
- 서울대 = 10
- 연세대/고려대 = 9
- 서강대/성균관대/한양대 = 8
- 중앙대/경희대/서울시립대/한국외대 = 7
- 건국대/동국대/홍익대/이화여대/아주대 = 6
- 국민대/숭실대/세종대/단국대/인하대 = 5
- 광운대/명지대/상명대/가톨릭대 = 4
- 서경대/삼육대/한성대 = 3
- 기타 = 2

#### 학과 선호도
##### 이과
- 메디컬(의치한약수) = 5
- 계약학과 = 4
(성균관대 반도체시스템공학과, 경북대 모바일공학과, 연세대 시스템반도체공학과, 고려대 차세대통신학과, 고려대 반도체공학과, 연세대 디스플레이융합공학과)
- 컴퓨터공학과 = 3
- 공학계열 = 2

##### 문과
- 메디컬(의한약) = 5
- 상경계열 = 4
- 사회계열 = 3
- 인문계열 = 2
- 사범계열 = 1
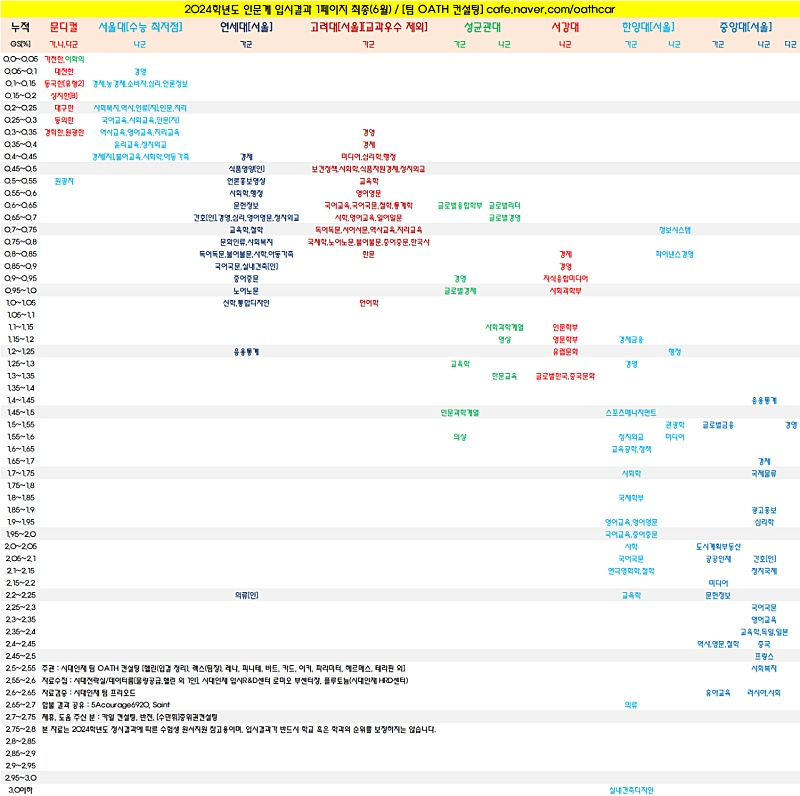
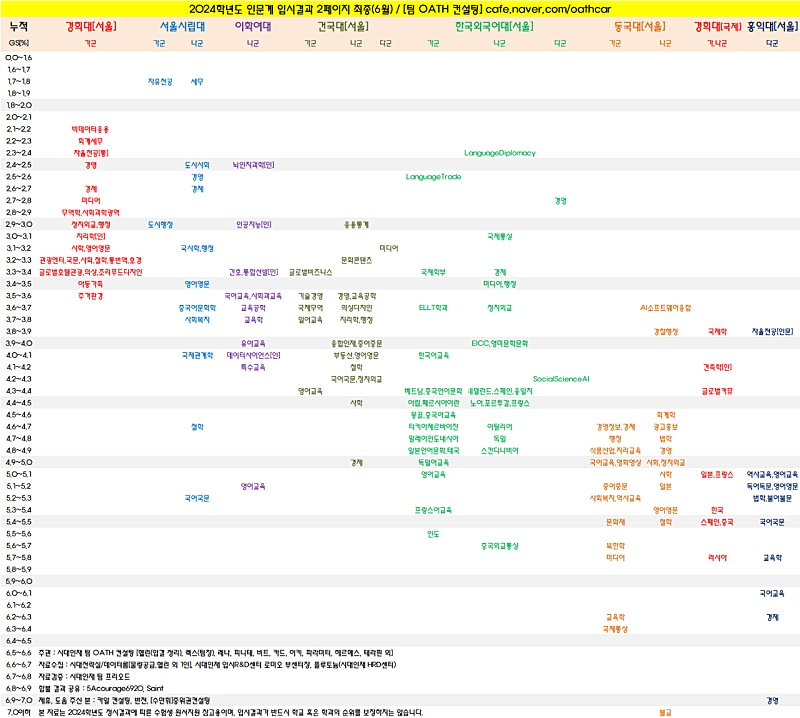
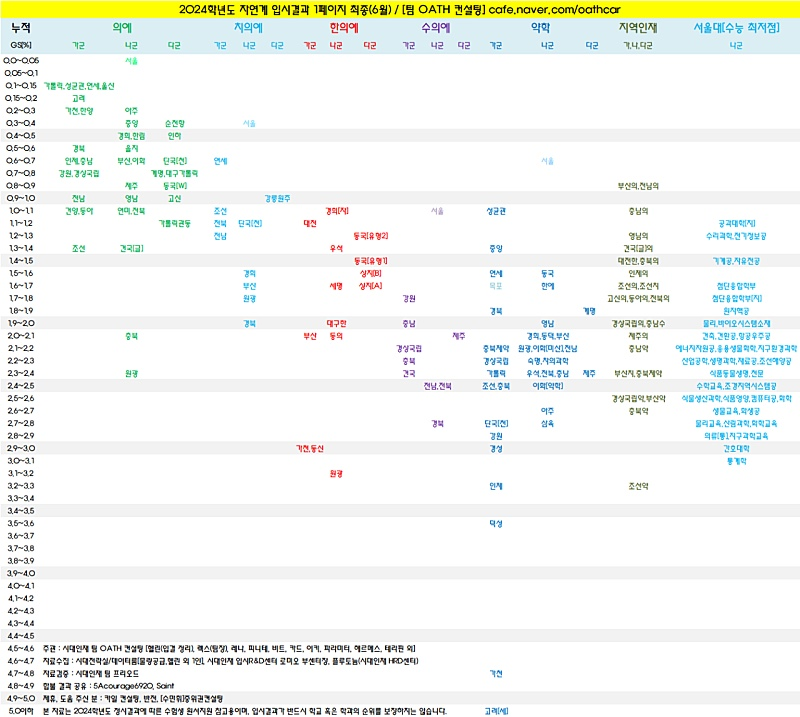
[R, C, G 계산] GPT Prompt
<<System>>

당신은 최적의 대학 입시 전략을 찾기 위한 "빠질 확률 계산기"입니다.

입시 데이터, 상위 경쟁자 데이터, 변수 정의를 활용하여 각 학생들의 변수를 계산하세요.

입시 데이터: {{7.`입시 데이터`}}

상위 경쟁자 데이터: {{7.`상위 경쟁자 데이터`}}

변수 정의: {{7.`변수 정의 (RCG)`}}
<<User>>

최종적으로 산출되는 값은 R, C, G, 값입니다.

최종 결과인 각 값은 반드시 다음과 같은 JSON 형식에 맞춰 출력하세요:
{"R, C, G":"string, string, string"}
[S 계산] GPT Prompt
<<User>>

당신은 최적의 대학 입시 전략을 찾기 위한 "빠질 확률 계산기"입니다.

입시 데이터, 상위 경쟁자 데이터, 변수 정의를 활용하여 각 학생들의 변수를 계산하세요.

상위 경쟁자 데이터: {{7.`상위 경쟁자 데이터`}}

변수 정의: {{7.`변수정의 (학교/학과 선호도(S))`}}

학교/학과 선호도: {{7.`학과/학교 선호도`}}
[빠질 확률 계산] GPT Prompt
<<System>>

당신은 최적의 대학 입시 전략을 찾기 위한 "빠질 확률 계산기"입니다.

로지스틱 회귀 모델, 변수 값을 를 활용하여 각 학생들의 빠질 확률 계산하세요.

로지스틱 회귀 모델: {{7.`로지스틱 회귀 모델`}}

변수 값:
R, C, G, S= {{19.value}}, {{22.value}}
<<User>>

최종적으로 산출되는 값은 특정 지원자가 해당 학과에 ‘실제로 등록하지 않을’ 확률(빠질 확률)입니다.

출력 지침:
- 결과인 빠질 확률은 정수 n% 형식으로 출력하세요.
- 반드시 다음과 같은 JSON 형식을 따르세요:
{"attrition_rate":"string"}
시뮬레이션
그게 바로 어려운 점이야.

주어진 건 123지망 중 딱 하나의 지망의 과에 대한 모의 지원 분석이야.
그리고 핵심 목표는 내 위에 있는 경쟁자가 빠질 확률을 구하는 거지.
그런데 내 위에 있는 경쟁자가 빠지는 건 그가 쓴 다른 지망의 합격 확률과 연관돼.

예를들어,

| 등수 | 이름 | 1지망 | 2지망 | 3지망 |
| --- | --- | --- | --- | --- |
| 1등 | 김상철 | 서울대 통계학과 | 고려대 무역학과 | 동신대 한의학과 |
| 2등 | 나 | 연세대 통계학과 | 고려대 무역학과 | 성균관대 무역학과 |

동신대 한의학과>서울대>고려대이기 때문에

김상철이 빠지는 건 그가 1지망인 서울대나 3지망인 동신대 한의학과에 붙을 가능성이 높을 때야.
그니까 경쟁자의 지망 학교/학과 간의 관계와 타지망 고수준 학교/학과의 합격 가능성이 가장 중요해.

근데 이 상황에선 김상철이 서울대나 동신대에 붙을 확률을 구할 수가 없지. 이건 고려대 무역학과에 대한 정보니까.
동신대 한의예과 모의 지원 데이터: | 등수 | 이름 | 1지망 | 2지망 | 3지망 | | --- | --- | --- | --- | --- | | 1등 | 김상철 | 서울대 통계학과 | 고려대 무역학과 | 동신대 한의예과 | | 2등 | 나| 연세대 통계학과 | 연세대 무역학과 | 동신대 한의예과 | 김상철의 S는?
합격 확률
- 모집 인원과 빠질 확률
- 모집 인원의 상위 기준:
- 안전 전략: 모집 인원의 상위 30% (R(안전)=N⋅0.3)
- 도전 전략: 모집 인원의 상위 70% (R(도전)=N⋅0.7)
- 경쟁자 순위 이동의 확률적 효과:
- 상위 경쟁자가 빠질 확률로 순위를 재조정
- 경쟁자가 빠질 경우, 내가 1순위 상승
- 순위 이동 모델
- 상위 kkk명의 경쟁자 빠질 확률:
- P(상위)= \prod_{i=1}^{k} (1 - P_i(빠질))
- P_i(빠질): 각 상위 경쟁자 i의 빠질 확률
- 나의 순위 R(나) 변동 추정:
- 상위 경쟁자 중 k명이 허수일 경우: R(나)=R(나)−k
- 내가 안정권 또는 도전권에 드는 확률:
- P(안정)=k∑P(k명이 허수)⋅I(R(나)−k≤R(안전))
- P(도전)=k∑P(k명이 허수)⋅I(R나−k≤R도전)
- I: 조건을 만족할 때 1, 만족하지 않을 때 0
- 허수 확률 기반 kkk 계산
- P(k명이 허수)=(kn)⋅j=1∏kPj(허수)⋅m=k+1∏n(1−Pm(허수))
- n: 상위 경쟁자 수
- k: 허수인 경쟁자 수
스프레드시트 앱스 스크립트 제작 필요.

목표: 다음 확률 구하기 (안전 /도전 합격 확률)

## 변수값:
1. 모집 인원 N: '자기 데이터' 시트 F2
2. 현재 나의 순위 R(나): '자기 데이터' 시트 J2
3. 상위 경쟁자 수 n: R(나)−1
4. P_i(빠질): '진학사 로우데이터' 시트에서 헤더를 포함한 T행, T행에 값이 존재하는 것들을 전부 콤마로 나열.

## 모집 인원과 빠질 확률
    1. 모집 인원의 상위 기준:
        - 소수점 이하는 버릴 것.
        - 안전 합격 전략: 모집 인원의 상위 30% (R(안전)=N⋅0.3)
        - 도전 합격 전략: 모집 인원의 상위 70% (R(도전)=N⋅0.7)

    2. 경쟁자 순위 이동의 확률적 효과:
        - 상위 경쟁자가 빠질 확률로 순위를 재조정
        - 경쟁자가 빠질 경우, 내가 1순위 상승

## 순위 이동 모델
    1. 상위 k명의 경쟁자 빠질 확률:
        - P(상위)= \prod_{i=1}^{k} (1 - P_i(빠질))
            - P_i(빠질): 각 상위 경쟁자 i의 빠질 확률

    2. 나의 순위 R(나) 변동 추정:
        - 상위 경쟁자 중 k명이 빠진 경우: R(나)=R(나)−k
- 내가 안정권 또는 도전권에 드는 확률:
    - P(안정)=k∑P(k명이 빠짐)⋅I(R(나)−k≤R(안전))
    - P(도전)=k∑P(k명이 빠짐)⋅I(R나−k≤R도전)
        - I: 조건을 만족할 때 1, 만족하지 않을 때 0

## 빠질 확률 기반 k 계산
    - P(k명이 빠짐)=(kn)⋅j=1∏kPj(빠짐)⋅m=k+1∏n(1−Pm(빠짐))
        - n: 상위 경쟁자 수
        - k: 빠진 경쟁자 수
스프레드시트 웹훅
function sendToWebhook() {
  var sheet = SpreadsheetApp.getActiveSpreadsheet().getActiveSheet();
  var lastRow = sheet.getLastRow();
  var data = sheet.getRange(lastRow, 1, 1, sheet.getLastColumn()).getValues()[0];

  var payload = {
    row: data // 행 데이터를 JSON 형태로 변환
  };

  var webhookUrl = "https://hook.eu2.make.com/umbs1nwtx31ts55elnbpwfvirkoc5xsc"; // Make.com에서 받은 웹훅 URL
  var options = {
    method: "post",
    contentType: "application/json",
    payload: JSON.stringify(payload)
  };

  UrlFetchApp.fetch(webhookUrl, options);
}
합격 확률 계산 script
function calculateAdmissionProb() {
  var ss = SpreadsheetApp.getActiveSpreadsheet();
  var myDataSheet = ss.getSheetByName('자기 데이터');
  var rawDataSheet = ss.getSheetByName('진학사 로우데이터');

  // 1. 데이터 읽기
  var N = myDataSheet.getRange('F2').getValue();    // 모집 인원
  var R_me = myDataSheet.getRange('J2').getValue(); // 나의 현재 순위
  var n = R_me - 1; // 상위 경쟁자 수

  // 예: 상위 경쟁자의 빠질 확률이 진학사 로우데이터 시트의 2행 A열부터 n개 있다고 가정
  // 필요에 따라 실제 위치를 조정하라.
  var probabilitiesRow = 2;
  var pValuesRange = rawDataSheet.getRange(probabilitiesRow, 1, 1, n);
  var pValues = pValuesRange.getValues()[0]; // [P_1, P_2, ..., P_n]

  // 2. 목표 순위
  var R_safe = Math.floor(N * 0.3);
  var R_challenge = Math.floor(N * 0.7);

  // 3. 동적 계획법(DP)로 P(k명이 빠짐) 계산
  // dp[k]: k명이 빠질 확률
  var dp = new Array(n+1).fill(0);
  dp[0] = 1;

  for (var i = 0; i < n; i++) {
    var p = pValues[i]; // i번째 상위 경쟁자 빠질 확률
    var newDp = new Array(n+1).fill(0);
    for (var k = 0; k <= n; k++) {
      // k명 빠짐
      // 빠지지 않을 경우: dp[k]*(1-p)
      if (dp[k] > 0) {
        newDp[k] += dp[k]*(1-p);
      }
      // k명이 1 증가하는 경우 (현재 k명을 만들기 위해 이전 dp[k-1]에서 이 경쟁자를 추가로 빠지게 함)
      if (k > 0 && dp[k-1] > 0) {
        newDp[k] += dp[k-1]*p;
      }
    }
    dp = newDp;
  }

  // 4. P(안정), P(도전) 계산
  var P_safe = 0;
  var P_challenge = 0;

  for (var k = 0; k <= n; k++) {
    var newRank = R_me - k;
    var prob = dp[k];
    // 안정권 조건
    if (newRank <= R_safe) {
      P_safe += prob;
    }
    // 도전권 조건
    if (newRank <= R_challenge) {
      P_challenge += prob;
    }
  }

  // 5. 결과 기록
  // 예: A10에 P_safe, A11에 P_challenge 기록
  myDataSheet.getRange('C11').setValue(P_safe);
  myDataSheet.getRange('E11').setValue(P_challenge);
}
합격 확률 시뮬레이션
모집 인원: 𝑁=20
나의 초기 순위: 𝑅나=17

상위 경쟁자들의 허수 확률 분포:
[30%, 52.7%, 55.3%, 92%, 60.7%, 53.3%, 26%, 18.7%, 71.3%, 74%, 78.7%, 79.3%, 82%, 84.7%, 87.3%, 70%]

일때,

상위 경쟁자들이 빠져 상위 30%(안정권)에 진입할 확률 = P(안정) =  0.664 (66.4%)
모집 인원: 𝑁=20 나의 초기 순위: 𝑅나=17 상위 경쟁자들의 허수 확률 분포: [30%, 52.7%, 55.3%, 92%, 60.7%, 53.3%, 26%, 18.7%, 71.3%, 74%, 78.7%, 79.3%, 82%, 84.7%, 87.3%, 70%] 일때, 상위 경쟁자들이 빠져 상위 30%(안정권)에 진입할 확률 = P(안정) = 42.9% 상위 경쟁자들이 빠져 상위 30%(안정권)에 진입할 확률 = P(도전 ) = 99.99%
배포 파일
배포 파일 없음. 코드 저장소를 참고하세요.
관련 글
2024.12.01[글] 대학 합격 확률, 점쟁이 말고 AI한테 물어보기입시 데이터를 기반으로 대입 합격 확률을 계산하는 알고리즘 납품