RNN에서 기울기 소실과 폭주 (On the difficulty of training Recurrent Neural Networks)
유형: 논문 · 저자: Razvan Pascanu, Tomas Mikolov, Yoshua Bengio · 출처: Universite de Montreal · 별점: ⭐️⭐️⭐️
결론
RNN: 현재 state가 이전 상태를 입력으로 받아 갱신되는 모델
기울기: 파라미터를 얼마나, 어느 방향으로 바꿔야 손실이 줄어드는지 알려주는 값
맥락
- 1990년대부터 폭주/소실 연구 → LSTM으로 완화
- 여전히 학습 신호의 시간 전달 구조 분석과 실무적으로 적용 가능한 안정화가 필요
기울기 소실과 폭주가 RNN 구조에서 야코비안 행렬 곱(시간축으로 같은 변환이 반복 곱)때문에 필연적으로 발생
RNN의 역전파(BPTT)에서 각 시점의 기울기는 여러 개의 시간 기여분(temporal contributions) 합으로 쪼개짐 ⇒ 장기 기여분이 지수적으로 0으로 가거나(소실) 지수적으로 커질 수(폭주) 있음
해결책
- 폭주에 대해 기울기 norm 클리핑으로 급격한 폭발을 제어
- 소실에 대해 norm이 너무 줄거나 늘지 않게 만드는 소프트 제약(정규화 항)을 추가
그러나 클리핑만으로는 장기 의존 문제를 충분히 못 품
- 클리핑 + 정규화(SGD-CR) 조합이 장기 시퀀스에서 성공률을 끌어올림
전제 및 문제 정의
RNN의 기본 형태
- 시점 t의 상태를 xt, 입력을 ut라고 두면, RNN은 일반적으로 형태로 정의
- 논문에서는 를 함께 적는다
- 여기서 핵심은 (순환 가중치)가 시간축 전체에서 반복 사용된다는 점
학습
- 손실 E는 각 시점 손실 Et의 합으로 두고, 역전파는 BPTT로 수행
- 전체 기울기 ∂E/∂θ = 각 시점 기울기들의 합
- 각 시점 기울기 ∂Et/∂θ = k≤t인 과거 시점들의 기여분 합
- 이때 각각의 과거 시점 k가 현재 시점 t의 손실에 미치는 영향 = (현재 오차) × (시간을 거슬러 전달되는 변환) × (즉시 영향)
문제 ⇒ 야코비안 행렬 곱
- 시간 전달 항 =
- 실수들의 곱이 반복되면 0으로 가거나 무한히 커질 수 있듯, 행렬의 곱도 어떤 방향에서는 0으로 줄고, 어떤 방향에서는 급격히 커질 수 있다
- 그래서 long term contributions이
- 소실: 시간이 멀수록 거의 0이 되어 학습 신호가 사라짐
- 폭주: 시간이 멀수록 지수적으로 커져 수치가 터짐
해결책
norm clipping
- 기울기 ĝ의 norm이 threshold를 넘으면, 방향은 유지하되 크기만 threshold로 줄여서 업데이트
- 현재 배치에서 계산한 기울기 벡터의 길이를 잰다.
- 너무 길면 길이를 강제로 줄인다
- 방향은 그대로이니 손실을 줄이는 방향이라는 성질을 유지
- 기울기 g에 대해 threshold가 c일 때,
- ||g|| ≤ c 이면 g̃ = g
- ||g|| > c 이면 g̃ = (c / ||g||) · g
- θ ← θ − η · g̃ = θ − η · c
- 한 스텝에서 파라미터가 이동할 수 있는 최대량 = η × c
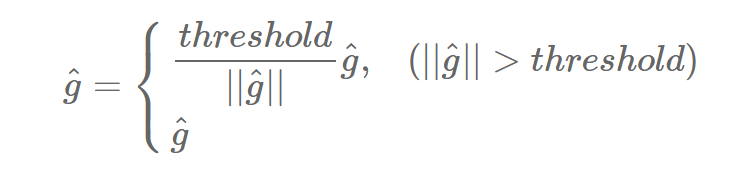
정규화 항(soft constraint)
- 클리핑만으로는 소실을 막을 수 없음 → 학습 목적에 정규화 항을 붙인다
- ∂xt/∂xk의 크기가 커지면, t시점 오차가 k시점 입력에도 민감해진다
- 그런데 모든 과거 입력이 다 중요하지는 않고, 중요하지 않은 입력들은 모델 입장에서 무시해야 할 요소
- 문제는 무시하려면 학습 신호(오차)가 필요한데, 소실이 있으면 그 신호 자체가 도달하지 못한다
- 그래서 너무 줄지도, 너무 늘지도 않게 만드는 제약을 걸되, 이것만으로 완전 보장은 못 하니 폭주 대비(클리핑)도 같이 함
병적 장기 의존 문제: Temporal Order
- 시퀀스 초반과 중간에 A/B가 나오고, 마지막에 그 순서를 맞추는 문제로 장기 기억이 필요
- 시퀀스가 길어지면(20 이상) 소실 때문에 SGD와 SGD-C(클리핑만)는 해결이 어려워진다
- 클리핑과 정규화를 같이 쓴 SGD-CR은 200 스텝까지 100% 성공률