트랜스포머 (Attention is All you need)
유형: 논문 · 저자: Ashish Vaswani, Noam Shazee, Niki Parma · 출처: Google · 별점: ⭐️⭐️⭐️⭐️⭐️
결론
- Seq2Seq 문제를 풀기 위해 순차 처리 구조(RNN, CNN)를 완전히 제거해도 된다는 가설에서 출발
- 문장 이해의 개념
- 순서대로 처리하는 능력 → 단어들 간의 전역 관계를 계산하는 능력
- Attention만으로 입력 전체를 한 번에 연결하는 Transformer 구조를 제안
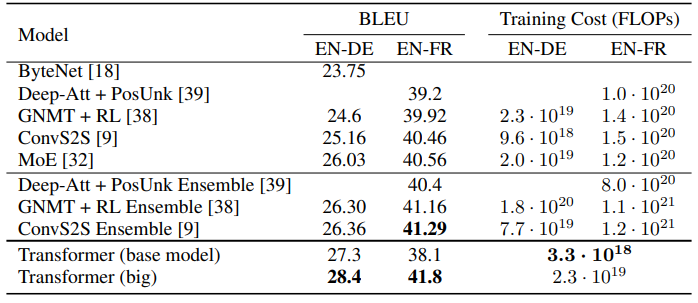
- Attention 메커니즘만으로 입력 전체의 관계를 파악하여 병렬 연산이 가능하고, 기존 모델보다 계산 효율성 및 성능이 우수
- 이 구조는 대부분의 현대 AI 모델(GPT, BERT 등)의 기반이 됨
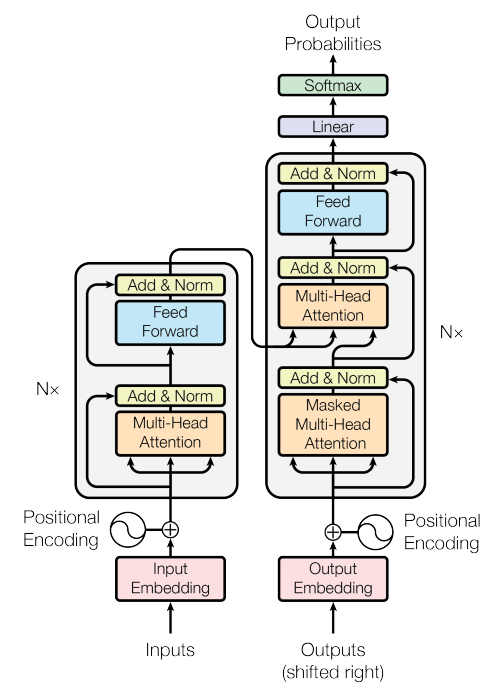
Transformer 아키텍처
전체 구조
- Encoder–Decoder 기반 구조를 유지
- 각 구성 요소는 여러 layer로 쌓여 있으며, 각 층은 Self-Attention + Feed-Forward 네트워크로 이루어짐
Position Encoding
- Transformer는 RNN과 달리 순서를 처리하지 않으므로, positional information를 임베딩에 추가
- sine/cosine 함수 기반 positional encoding을 입력 임베딩에 더하는 방식으로 위치 정보를 인코딩
Self-Attention
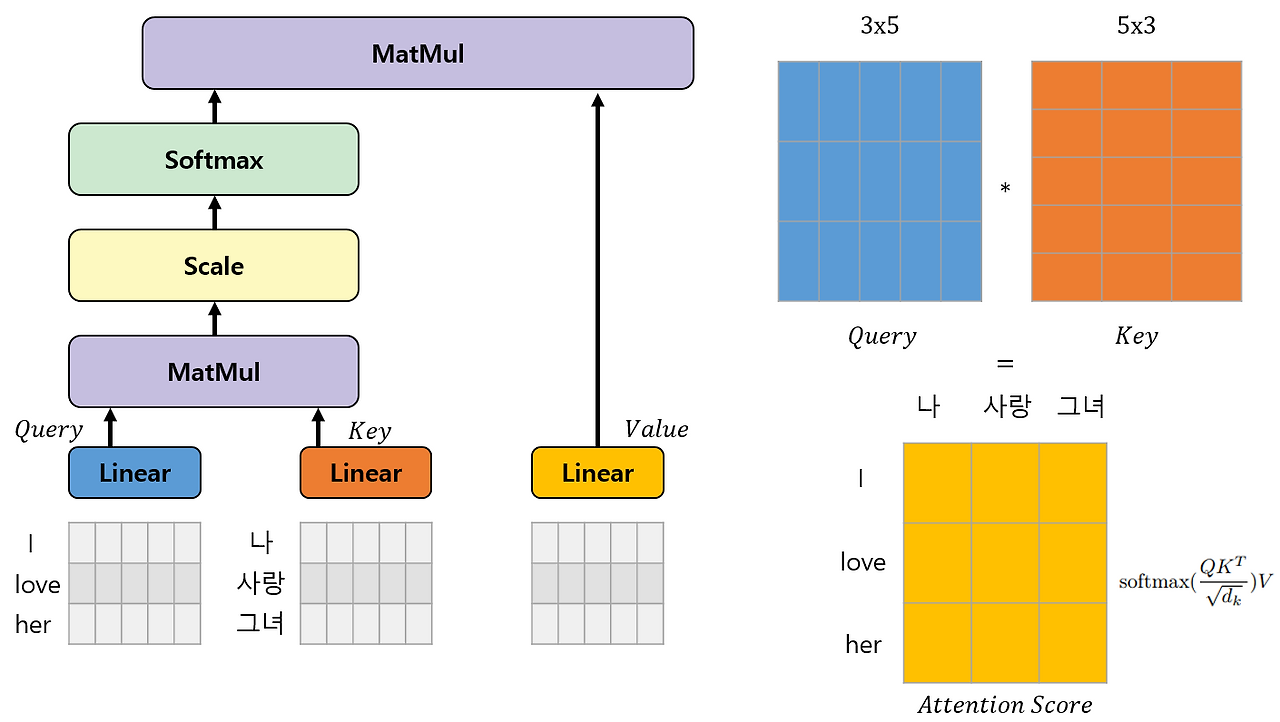
- 입력 시퀀스의 모든 토큰이 서로를 참조(attention)하여 의미 관계를 계산
- 각 토큰은 Query(Q), Key(K), Value(V) 벡터로 변환되어 점곱 기반 유사도로 attention score를 계산
- 해당 값으로 context representation을 생성
Multi-Head Attention
- Self-Attention을 병렬 head 여러 개로 적용하여 서로 다른 하위 표현(feature subspace)을 동시에 학습
- 병렬 head의 출력들을 concat하고 linear projection을 거쳐 최종 Attention 결과를 구함