LLM의 컨텍스트 길이 제한을 극복하기 위한 재귀 호출 아키텍처 (Recursive Language Models(RLM))
유형: 논문 · 저자: Alex L. Zhang, Tim Kraska, OmarKhattab · 출처: MIT CSAIL · 별점: ⭐️⭐️⭐️⭐️
- 긴 프롬프트를 모델에 그대로 넣는 방식이 왜 본질적으로 깨지는지 짚고, 그 대안으로 Recursive Language Models (RLMs) 라는 추론 전략을 제안
- 긴 프롬프트를 신경망 입력이 아니라 외부 환경의 데이터로 취급하고, LLM이 코드를 써서 필요한 부분만 꺼내 보고, 쪼개고, 자기 자신을 재귀 호출하며 처리하게 만듦
- “컨텍스트 윈도우”를 물리적으로 늘리는 게 아니라, inference-time compute(추론 시 계산) 를 더 쓰되 읽는 방식을 바꿔서 수백만~천만 토큰급 입력을 다루려는 시도
핵심
- 기존 LLM의 한계
- Transformer 기반 모델은 고정된 컨텍스트 윈도우 길이 제한이 존재한다.
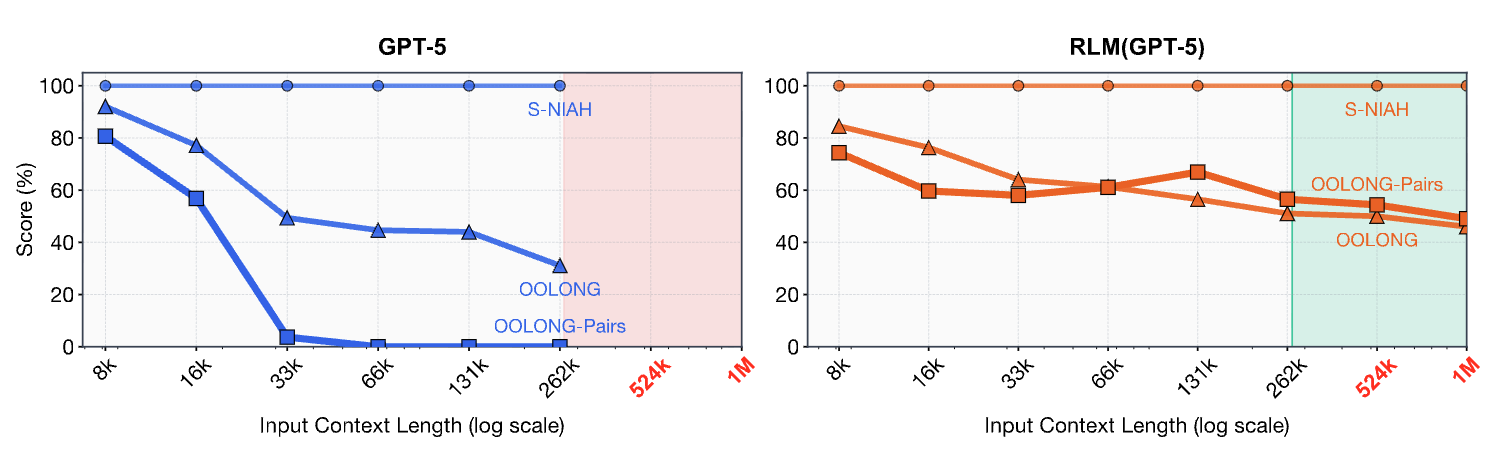
- 긴 텍스트에서는 context rot이 발생해 성능이 크게 저하된다.
- RLM
- RLM은 아키텍처 변경이 아니라 추론 시 실행 전략을 개선하여 긴 입력을 처리
- 긴 입력을 외부 환경으로 취급하고 스스로 분할·탐색·재귀 호출을 통해 처리하게 함으로써 Context Window 제한 해결
- 기존 LLM이나 요약/검색 기반 장기 컨텍스트 방식보다 성능이 크게 우수하며, 비용 또한 비슷하거나 낮게 유지
- 프로그래밍 환경(REPL) 활용
- 긴 문서/입력 전체를 외부 환경(Python REPL)에 저장하고, 코드로 접근, 검색, 분할하도록 함
| 방식 | 텍스트 입력 처리 전략 | 단점 |
|---|---|---|
| LLM | 텍스트를 한 번에 넣어 읽음 | Token 제한, 성능 급락 |
| RAG | 요약/검색으로 일부만 사용 | 정보 손실 |
| RLM | 텍스트를 환경으로 두고 필요한 조각만 프로그램처럼 처리 | 동적 코드+재귀 호출 필요 |
개념
- RLM = 사서 + 조수
- 사서는 책을 한꺼번에 암기하지 않고 필요한 장만 꺼내 본다
- 필요하면 조수에게 맡기고 최종적으로 정답을 종합한다.
- Root LM
- 질문을 받으면 작업을 순서대로 설계하고 그 설계에 따라 행동(코드 실행, 분해, 재귀 호출)을 계속 한다
- REPL (Read-Eval-Print Loop)
- 코드를 한 줄 실행하고 결과를 바로 보고 다음 코드를 이어가는 대화형 실행 환경
- 모델이
print(context[:10000])같은 코드를 실행해 문서의 일부를 화면에 띄워 보고, 다음 행동을 결정
- Python REPL
- Prompt 전체를 REPL의 변수로 저장하고
- Root LM이 코드로 직접 조작하면서 재귀 호출하는 구조를 만든다
- peek
- 전체를 다 읽지 않고 일부만 살짝 확인
- 앞 1만 글자, 특정 키워드 주변 500글자 같은 미리보기로 어디에 뭐가 있는지 탐색
- decompose
- 큰 문제를 작은 하위 문제로 쪼개기
- 문서를 “섹션 단위”나 “문서 묶음 단위”로 나눠서 각각을 따로 처리하도록 작업 목록을 만듦
- recursively call itself
- 모델이 하위 문제를 풀기 위해 더 작은 모델 호출을 여러 번 사용
- Root LM은 큰 문제를 받는다
- 세부 설명이 필요하면 자기 자신에게 다시 질문을 던진다
- 작은 조각만 주고 그 답을 받아서 종합한다
- 루트 모델(GPT-5)이 전체 전략을 짜고, 서브 모델(GPT-5-mini 등)이 각 조각을 처리하게 하는 계층 구조를 사용
- 모델이 하위 문제를 풀기 위해 더 작은 모델 호출을 여러 번 사용
긴 프롬프트를 신경망에 넣지 말고 환경 취급한다
- 기존 방식
- 1,000페이지 문서를 통째로 모델 입력에 넣으려 함
- 모델은 입력을 한 번에 훑어야 하고, 길어질수록 “앞부분을 점점 잘 못 쓰는 현상”이 커짐
- 논문은 이 현상을 context rot로 지칭
- 모델 컨텍스트 윈도우가 272K 토큰이라고 하자 (논문 Figure 1 설명에서 GPT-5 맥락 길이 언급)
- 입력이 1M 토큰이면 통째로는 못 넣음
- 1,000페이지 문서를 통째로 모델 입력에 넣으려 함
- RLM 방식
- 1,000페이지 문서는 모델 밖에 둠
- 모델은 문서 전체를 들고 있는 대신, 지금 필요한 2~3페이지를 꺼내서 처리하는 절차를 반복
- 문서 1M 토큰은 외부에 그대로 둠
- 모델은 지금 필요한 부분만, 예를 들어 50K 토큰 단위로 꺼내서 판단
- 그 판단 결과(요약이 아니라 결론에 필요한 중간 산출물)만 작은 메모로 축적
- 1,000페이지 문서는 모델 밖에 둠
기존 재귀 분해 접근 한계
- 이전 방법들은 “생각을 쪼개기”는 했지만, 원본 자료에 무제한으로 접근하기는 못 함
- 입력이 어느 임계값을 넘으면, 결국 마지막엔 모델 입력에 넣을 수 있는 만큼만으로 다시 돌아가게 됨
- “입력=모델 입력”이라는 고정 관념
- NLP 시스템 대부분이 ‘토큰 시퀀스를 넣는다’가 기본 인터페이스였고, 그 밖의 접근은 RAG 같은 “부가 기능”으로 취급됨
- RLM은 인터페이스를 유지하면서도(문자열 입력/문자열 출력) 내부에서 “환경+코드+재귀 호출”로 패러다임을 바꿈
- LLM이 코드를 꽤 잘 쓰고, 도구 호출을 자연스럽게 할 만큼 성숙해졌음
- REPL에서 탐색하고, chunking하고, 서브 호출을 배치하는 건 툴 사용 능력이 받쳐줘야 함
- 논문 시스템 프롬프트가 가능한 한 REPL과 sub-LLM을 많이 쓰라 같은 지시를 포함하는 것도 이 전제를 노골화한 사례