데이터 중심 AI를 위한 워크플로우 자동화 프레임워크 (DataFlow: An LLM-Driven Framework for Unified Data Preparation and Workflow Automation in the Era of Data-Centric AI)
유형: 논문 · 저자: Hao Liang, Xiaochen Ma, Zhou Liu · 출처: Peking University · 별점: ⭐️⭐️⭐️
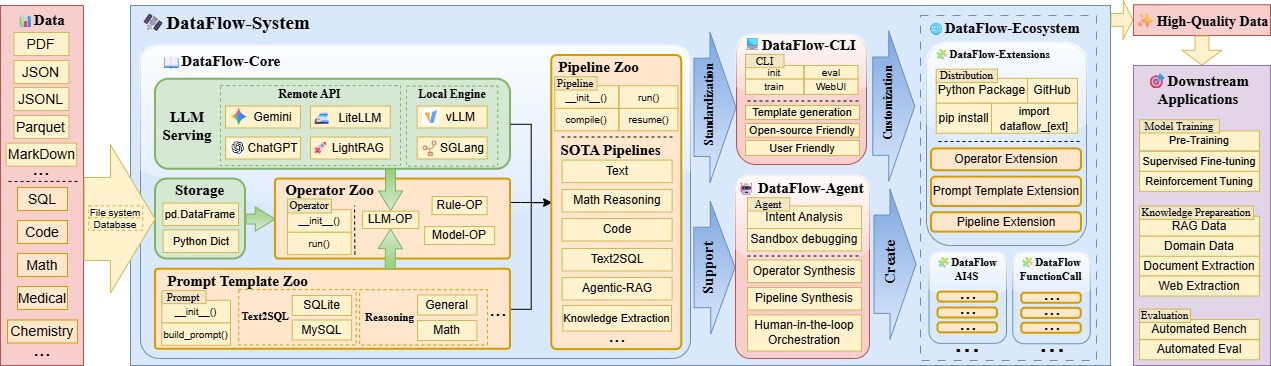
DataFlow — Data Centric AI System
Installation | DataFlow Documentation
연산자
데이터 처리를 위한 최소 단위인 연산자를 모듈화하여 제공
- 일반 연산자(Generic Operators): 텍스트 평가, 처리, 합성 등 범용적인 기능을 수행
- 도메인 특화 연산자(Domain-Specific Operators): 40개 이상의 의료, 금융, 법률 등 특정 분야에 특화
- 평가 연산자(Evaluation Operators): 데이터의 품질을 6가지 차원에서 종합적으로 평가
General Data Evaluation Operators | DataFlow Documentation
논문 내용
기존 AI 개발
- 사람이 프롬프트로 데이터 생성
- 결과를 눈으로 보고 “이상한 것” 삭제
- 또 다른 사람이 기준을 바꿔 다시 정제
- 왜 성능이 올랐는지는 아무도 정확히 설명 못함
논문의 전제
- LLM 성능의 병목은 데이터가 만들어지는 방식에 있다
- “왜 모델은 레이어, 블록, 아키텍처로 정교하게 설계하면서 데이터는 아직도 스크립트와 감각에 맡기고 있지?”
Data Preparation (데이터 준비)
- AI 학습에 쓰일 데이터를 만들고, 고르고, 다듬는 모든 과정
- 사람의 기준으로 이뤄졌다
- 문제
- 다시 만들 수 없다
- 기준이 공유되지 않는다
- 성능이 오른 이유를 설명할 수 없다
- “데이터 준비를 공장처럼 만들자” → DataFlow
- DataFlow
- 생성
- 평가
- 필터
- 정제
구조
- 모듈형 연산자 (Operators): 생성(Generation), 평가(Evaluation), 필터(Filter), 정제(Refinement) 기반 약 200개의 재사용 가능한 연산자
- PyTorch 스타일 API: 파이프라인 생성 및 디버깅 중심 설계
- 도메인 일반 파이프라인: 텍스트, 수학적 추론, 코드, Text-to-SQL, RAG, 대규모 지식 추출 등 6개 표준화 파이프라인 포함
- DataFlow Agent
- LLM에게 데이터를 만들라고 시키는 게 아니라, 만드는 방법을 설계하게 함
- “의도만 주면 LLM이 이프라인 설계를 할 수 있다”
- 자연어로 파이프라인 정의를 입력하면 → 연산자 합성 → 파이프라인 계획 → 검증 과정을 자동 수행
주요 성능 성과
- Text-to-SQL 실행 정확도 +3% 개선
- 코드 벤치마크에서 평균 +7% 성능 향상
- 수학 추론 벤치마크(MATH, GSM8K, AIME)에서 1–3 포인트 향상
- DataFlow로 생성된 10K 샘플 데이터셋으로 1M 학습 데이터 기반 모델과 동등 이상 성능 달성
정리
비전문적 작업 방식
- LLM으로 데이터 생성 → 결과 CSV 저장 → 끝
- 프롬프트를 노션이나 메모에 따로 관리
- “이번엔 temperature 0.7이 잘 먹히네” 같은 감각 의존
- 데이터 필터링 기준이 사람 머릿속에만 있음
- 재실행하면 결과가 달라져도 이유를 모름
실행 지침
DataFlow:github:: 데이터 중심 AI를 위한, LLM 기반 통합 데이터 준비 및 워크플로우 자동화 프레임워크 소개